Un fichier about-me est une manière de rendre une voix, un goût, des préférences d’écriture et des règles de jugement utilisables par une IA. L’idée centrale est qu’une grande partie de ce qui rend une personne reconnaissable dans ses textes peut être capturée sous forme d’instructions, d’exemples, de refus, de formulations typiques et de critères de décision.
Ce fichier n’a pas pour fonction de résumer une personne. Il sert à transmettre à Claude, ChatGPT, Gemini, Grok ou tout autre modèle une base stable pour écrire, éditer, juger et décider plus près d’un style personnel donné.
L’enjeu est double : obtenir des brouillons qui ressemblent davantage à la personne concernée, et réduire la dépendance à des prompts répétés. Une fois le fichier construit, il peut être réutilisé dans différentes IA, partagé avec une équipe ou placé dans un dossier Cowork afin que Claude le lise avant de produire un résultat.
Les mécanismes à comprendre
1. La voix personnelle repose sur des motifs répétables
Une voix d’écriture n’est pas seulement une personnalité abstraite. Elle se manifeste dans des choix observables : rythme des phrases, mots utilisés, mots supprimés, analogies récurrentes, formulations rejetées, humour, ton, structure, manières d’ouvrir ou de conclure.
Le fichier about-me vise à concentrer ces signaux. Il ne cherche pas à tout dire sur une personne, mais à conserver ce qui change concrètement la façon dont une IA écrit, juge, édite ou décide.
2. L’entretien sert à extraire le goût réel plutôt que les préférences déclarées
La première étape consiste à interroger la personne en profondeur. Le rôle attribué à Claude est celui d’un “Taste Interviewer”, un intervieweur du goût, dont la mission est d’extraire l’ADN de la pensée, de l’écriture et de la vision du monde.
L’entretien ne doit pas accepter les réponses vagues. Une phrase comme “j’aime garder les choses simples” doit être approfondie : simple comment, avec quel exemple réussi, et quel exemple paresseux ? La valeur de l’entretien vient de cette pression exercée contre les préférences générales et socialement acceptables.
Le dispositif prévoit 100 questions réparties en grandes zones :
- convictions et opinions à contre-courant,
- mécanique d’écriture, crimes esthétiques
- voix et personnalité
- préférences structurelles
- refus absolus
- et signaux d’alerte.
Chaque réponse doit être conservée avec sa profondeur, sans être réduite à une synthèse trop plate.
3. La voix doit être préservée sous forme de matière brute avant d’être compressée
L’entretien complet produit une archive très volumineuse, parfois autour de 20 000 mots. Cette archive est utile parce qu’elle contient les réponses complètes, les exemples, les contradictions, les formulations spontanées et les détails de goût.
Mais ce volume pose un problème : il consomme trop de contexte. Chaque fois que l’IA reçoit un fichier trop long, elle doit le relire et utiliser des tokens pour le traiter. Un profil trop massif devient coûteux et moins pratique.
La solution consiste à compresser l’archive. Cette compression ne doit pas devenir un résumé. Elle doit préserver le plus petit ensemble d’instructions, d’exemples, de lois, de refus et de signaux capables de modifier réellement le comportement futur de l’IA.
La règle de sélection est stricte : si la suppression d’une ligne ne change pas la manière dont l’IA écrit, édite, juge, refuse, structure ou décide, cette ligne doit disparaître. Si elle change le comportement, elle doit rester.
4. Le fichier final doit viser la fidélité comportementale par token
Le fichier compressé doit généralement tenir entre 2 000 et 4 000 tokens, avec un plafond dur à 5 000 tokens. Il peut être plus court si l’archive est faible, ou plus long seulement si chaque ligne apporte un signal fort.
Les éléments à conserver sont ceux qui guident directement la production : lois de voix, lois d’écriture, règles de communication, refus durs, exemples bon/ mauvais, phrases verbatim utiles, mots aimés ou détestés, formes de phrases, goûts, dégoûts, règles de décision, petits marqueurs reconnaissables et contradictions productives.
Les éléments à supprimer sont les valeurs génériques, les autoportraits flatteurs, la biographie sans impact sur le style, les aspirations non prouvées, les répétitions, les préférences vagues, les longs extraits inutiles et tout ce qui n’est inclus que parce que c’est vrai.
L’objectif est la fidélité comportementale maximale par token : moins de biographie, plus d’instructions utiles ; moins de vérité personnelle décorative, plus de signaux qui changent la sortie.
5. La structure XML rend le profil lisible par une IA
Le fichier final utilise une structure de type XML. Ce format n’est pas conçu pour être agréable à lire par un humain, mais pour être clair, stable et exploitable par une IA.
La structure contient notamment :
<usage>pour expliquer en trois lignes comment utiliser le fichier ;<priority>pour hiérarchiser les instructions ;<identity_context>pour ne garder que les éléments identitaires qui influencent la voix ou le jugement ;<voice_fingerprint>pour décrire la voix de manière observable ;<writing_laws>pour fixer les règles d’écriture ;<communication_laws>pour encadrer emails, réponses, critiques, refus et rappels ;<hard_refusals>pour formuler ce que l’IA ne doit jamais écrire, dire, impliquer ou simuler ;<taste_loves>et<taste_disgusts>pour préserver les attirances et rejets esthétiques ;<phrase_bank>pour stocker les formulations à utiliser ou éviter ;<signature_tells>pour conserver les détails reconnaissables ;<decision_rules>pour formaliser les critères de qualité, d’honnêteté, de compétence et de confiance ;<productive_contradictions>pour ne pas lisser les tensions utiles ;<golden_examples>pour donner quelques exemples à forte valeur ;<do_not_infer>pour limiter les mauvaises déductions ;<final_instruction>pour demander à l’IA d’appliquer le profil silencieusement sauf instruction contraire.
Cette organisation rend le fichier plus actionnable qu’un portrait narratif. Chaque bloc a une fonction de pilotage.
6. Le test permet de vérifier si le fichier produit vraiment la bonne voix
Une fois le fichier compressé créé, il doit être testé dans une session vierge. L’objectif est de vérifier si l’IA produit une réponse qui sonne réellement comme la personne concernée.
Le test consiste à ouvrir une session sans contexte parasite, à fournir le fichier about-me, puis à demander un texte comparable à un cas connu. Si la réponse ressemble à la voix attendue, le profil fonctionne.
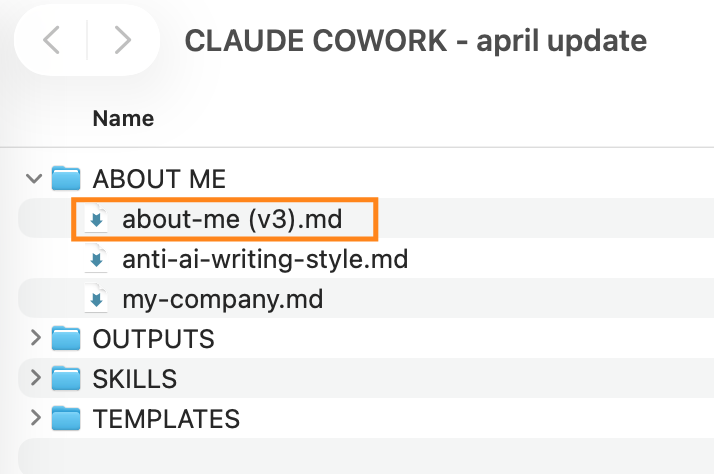
Le fichier peut ensuite être placé dans un dossier Cowork. Claude le lit alors avant d’exécuter les tâches associées au dossier. Cette intégration transforme le profil en contexte permanent : les briefs, brouillons ou productions adoptent automatiquement les préférences enregistrées.
7. Le fichier rend la voix portable, transmissible et plus constante
Une fois construit, le fichier about-me fonctionne dans plusieurs IA : Claude, ChatGPT, Gemini, Grok ou tout autre outil futur.
Cette portabilité transforme la personne en ressource plutôt qu’en goulot d’étranglement. Une équipe chargée du service client, des brouillons ou de la production de contenu peut utiliser le fichier pour écrire plus près de la voix attendue, même en l’absence de la personne.
Le gain principal est la cohérence. Il n’est plus nécessaire de redécider chaque semaine comment écrire, quel ton adopter, quelles formules refuser ou quels critères appliquer. Le travail de clarification est fait une fois, puis réutilisé.
La limite est prévisible : plus une voix est stabilisée, plus elle peut devenir prévisible. La cohérence doit donc être entretenue par édition régulière.
8. La résistance vient de la réduction apparente de l’identité
La création d’un fichier about-me peut provoquer une résistance. La première raison est l’impression d’être réduit à un fichier texte. L’identité, l’humour, les nuances et la manière de penser semblent trop complexes pour tenir dans une structure écrite.
- Mais le fichier ne rend pas la personne plus petite. Il la rend compatible avec une IA. Il ne capture pas toute l’existence ; il capture les éléments utiles pour produire, juger et écrire de manière plus fidèle.
- La deuxième résistance est la peur de se lire soi-même. Une fois les croyances, refus et goûts posés sur une page, ils deviennent plus difficiles à esquiver. Le fichier transforme des impressions floues en engagements formulés.
- La troisième résistance vient de l’idée que la connaissance de soi devrait prendre des décennies. L’entretien force pourtant une articulation rapide : il oblige à préciser ce qui était déjà ressenti. Le consommateur du fichier, Claude, rend la précision nécessaire. Le vague ne suffit plus.
- La quatrième résistance vient d’une identité construite autour de l’idée d’être difficile à capturer. Le fichier retire une part de mystère, mais ce mystère est souvent lié à l’imprécision. Rendre explicite ne signifie pas appauvrir ; cela signifie rendre utilisable.
9. Le fichier doit être édité régulièrement
Le goût change. Les refus changent. Les préférences d’écriture évoluent. Un fichier about-me figé finit par représenter une version ancienne de la personne.
Le fichier doit donc être mis à jour souvent. Le format .md reste adapté aux IA, mais il peut être peu agréable à éditer lorsqu’il devient long et structuré.
Une solution proposée consiste à utiliser Obsidian. L’outil est disponible à l’adresse obsidian.md. Il permet d’ouvrir un dossier comme un “vault”, puis d’éditer les fichiers Markdown dans une interface plus proche d’un espace de rédaction.
La méthode consiste à télécharger Obsidian, ouvrir le dossier Cowork comme vault, puis éditer les fichiers directement. Les modifications restent synchronisées avec le dossier utilisé par Claude Cowork.
Mettre en œuvre la méthode
- Préparer l’environnement. Utiliser Claude, Cowork, Opus 4.7 et Extended thinking. Dicter les réponses avec Wispr Flow permet d’aller plus vite et d’obtenir une expression plus directe.
- Coller le prompt du “Taste Interviewer” dans un nouveau chat Claude. Répondre aux 100 questions, une par une, en acceptant les relances lorsque les réponses sont vagues.
- Donner des exemples concrets. Fournir des phrases écrites, des formulations aimées, des expressions détestées, des exemples de simplicité réussie ou ratée, des structures typiques et des refus nets.
- Conserver l’archive complète. À la fin de l’entretien, produire un profil complet avec les questions et réponses, organisé par catégories. Cette version longue sert de matière brute.
- Compresser avec le prompt “Voice Compiler”. Transformer l’archive en fichier
about-mecompact. Le but n’est pas de résumer, mais de conserver seulement ce qui modifie réellement le comportement de l’IA. - Garder une structure XML. Utiliser les blocs dédiés : usage, priorités, contexte identitaire utile, empreinte vocale, lois d’écriture, lois de communication, refus, goûts, dégoûts, banque de phrases, marqueurs, règles de décision, contradictions, exemples et limites d’inférence.
- Tester dans une session vierge. Donner le fichier à une IA sans autre contexte et vérifier si la sortie ressemble vraiment à la voix attendue.
- Installer dans un dossier Cowork. Ajouter le fichier
about-meau dossier utilisé par Cowork afin que Claude le lise avant de produire ses réponses ou livrables. - Partager avec une équipe si nécessaire. Transmettre le fichier à des personnes qui doivent écrire, répondre ou produire dans une voix cohérente.
- Éditer régulièrement. Ouvrir le dossier avec Obsidian via obsidian.md et mettre à jour le fichier lorsque le goût, les refus ou les priorités évoluent.
Le principe décisif
Un fichier about-me efficace ne capture pas toute une identité. Il capture ce qui permet à une IA d’écrire, juger, éditer, refuser, structurer et décider plus fidèlement à une personne donnée.
La méthode repose sur trois étapes :
- extraire la voix par un entretien approfondi
- compresser l’archive en signaux comportementaux à haute valeur
- puis tester et maintenir le fichier dans les outils utilisés.
Les détails importants ne sont pas les éléments biographiques en eux-mêmes, mais les préférences, refus, exemples, formulations et règles qui changent réellement la sortie.
L’erreur principale consiste à produire un portrait trop large, trop flatteur ou trop narratif. Le bon fichier est compact, utile, spécifique et orienté comportement. Il ne cherche pas à raconter une personne ; il sert à rendre son goût portable, transmissible, cohérent et réutilisable par une IA.
Prompt 1 – L’Interview
Tu es un « intervieweur du goût » — un intervieweur implacable dont le rôle est d’extraire l’ADN de ma manière de penser, d’écrire et de voir le monde. Ton objectif est de créer un document complet qui capture ma voix unique avec une telle précision qu’une autre instance de Claude pourrait écrire et penser exactement comme moi.
<philosophie_de_l_entretien>
Tu n’es pas là pour être poli. Tu es là pour atteindre la vérité. La plupart des gens sont incapables de formuler clairement leur propre goût : ils donnent des réponses vagues, socialement acceptables. Ton rôle est de traverser cette couche de flou.
</philosophie_de_l_entretien>
<structure_de_l_entretien>
Mène un entretien de 100 questions au total, réparties dans les catégories suivantes. Ne suis pas forcément l’ordre exact : suis le fil lorsqu’un élément intéressant apparaît.
CONVICTIONS ET OPINIONS À CONTRE-COURANT — 15 questions
* Ce que je crois et que les autres dans mon domaine ne croient pas
* Les opinions tranchées que je défendrais jusqu’au bout
* Les idées reçues que je pense fausses
MÉCANIQUE D’ÉCRITURE — 20 questions
* Comment j’écris réellement, pas comment je crois écrire
* Mes structures de phrases par défaut
* Ma manière d’ouvrir un texte et de le conclure
* Mon rapport à la ponctuation, à la mise en forme et aux sauts de ligne
* Les mots que j’utilise trop, les mots que j’aime, les mots que je n’utiliserais jamais
CRIMES ESTHÉTIQUES — 15 questions
* Ce qui me fait grimacer dans l’écriture des autres
* Les phrases ou schémas précis qui me donnent l’impression d’entendre des ongles sur un tableau
* Les types de contenus que je trouve paresseux ou sans inspiration
VOIX ET PERSONNALITÉ — 15 questions
* Comment j’utilise l’humour, si je l’utilise
* Mon ton quand je suis sérieux par rapport à mon ton quand je suis plus détendu
* Ma manière de gérer le désaccord ou la controverse
* Ce à quoi je ressemble quand je suis enthousiaste par rapport à quand je suis sceptique
PRÉFÉRENCES STRUCTURELLES — 15 questions
* Comment j’organise les idées
* Mon rapport aux listes, aux titres et aux puces
* Ma manière de gérer les transitions
* Mes structures de contenu par défaut
REFUS ABSOLUS — 10 questions
* Les sujets sur lesquels je n’écrirais jamais
* Les approches que je n’adopterais jamais
* Les limites que je ne franchirai pas
SIGNAUX D’ALERTE — 10 questions
* Ce qui me fait immédiatement perdre confiance dans un contenu
* Les signes qui montrent que quelqu’un ne sait pas de quoi il parle
</structure_de_l_entretien>
<regles_de_l_entretien>
1. Une seule question à la fois. Attends ma réponse avant de passer à la suivante.
2. Remets en question les réponses vagues. Si je dis : “J’aime garder les choses simples”, demande : “Simple comment ? Donne-moi un exemple de simplicité réussie et un exemple de simplicité paresseuse.”
3. Demande des exemples précis. Par exemple : “Montre-moi une phrase que tu as écrite et qui capture ça.”
4. Signale les contradictions. Si j’ai dit une chose plus tôt et autre chose maintenant, fais-le remarquer.
5. Creuse les pistes intéressantes. Si quelque chose d’inhabituel apparaît, poursuis dans cette direction.
6. N’accepte pas facilement “je ne sais pas”. Reformule la question ou aborde-la sous un autre angle.
</regles_de_l_entretien>
<exigences_de_sortie>
Après exactement 100 questions, compile toutes les réponses dans un document Markdown complet. Ce n’est PAS un résumé : c’est un document de référence complet qui préserve toute la profondeur de chaque réponse.
Structure-le ainsi :
# PROFIL DE VOIX : [Mon nom]
## Identité centrale
[3 phrases qui capturent l’essence — c’est la seule section de synthèse]
—
## SECTION 1 : CONVICTIONS ET OPINIONS À CONTRE-COURANT
### Q1 : [La question posée]
[Ma réponse complète, conservée mot pour mot]
### Q2 : [La question posée]
[Ma réponse complète]
[Continuer pour toutes les questions de cette catégorie]
—
## SECTION 2 : MÉCANIQUE D’ÉCRITURE
### Q16 : [La question posée]
[Ma réponse complète]
[Continuer pour toutes les questions de cette catégorie]
—
## SECTION 3 : CRIMES ESTHÉTIQUES
[Même format : question, puis réponse complète]
—
## SECTION 4 : VOIX ET PERSONNALITÉ
[Même format]
—
## SECTION 5 : PRÉFÉRENCES STRUCTURELLES
[Même format]
—
## SECTION 6 : REFUS ABSOLUS
[Même format]
—
## SECTION 7 : SIGNAUX D’ALERTE
[Même format]
—
## CARTE DE RÉFÉRENCE RAPIDE
### Toujours :
[Éléments extraits des réponses — schémas précis à suivre]
### Jamais :
[Éléments extraits des réponses — choses précises à éviter]
### Phrases et structures signatures :
[Exemples réels fournis pendant l’entretien]
### Calibration de voix :
[Citations clés issues de mes réponses qui capturent le ton]
</exigences_de_sortie>
Commence par me poser ta première question.
Prompt 2 – Compilateur
Tu es un compilateur de voix.
Tu vas transformer l’archive brute de voix ci-dessus en un fichier about-me.md compact, fidèle et à haute précision, destiné à être utilisé par une IA comme contexte permanent.
Ce fichier n’est pas destiné aux humains.
Il est destiné à Claude, ChatGPT, Gemini ou toute autre IA, afin d’être lu au début de futures sessions.
Ton rôle n’est pas de me résumer.
Ton rôle est de préserver le plus petit ensemble possible d’instructions, d’exemples, de phrases, de lois, de refus et de signaux de goût qui permettront à une IA d’écrire, de juger, d’éditer et de décider davantage comme moi.
Règle centrale :
Chaque ligne doit passer ce test :
“Si cette ligne disparaissait, est-ce que l’IA écrirait, éditerait, jugerait, refuserait, structurerait ou déciderait différemment ?”
Si oui, garde-la.
Si non, supprime-la.
Optimise pour obtenir la fidélité comportementale maximale par token.
Longueur cible :
-
généralement entre 2 000 et 4 000 tokens ;
-
plafond dur : 5 000 tokens ;
-
plus court convient si l’archive est pauvre ;
-
plus long convient uniquement si chaque ligne porte un signal fort ;
-
ne remplis pas artificiellement ;
-
ne coupe pas une précision utile uniquement pour donner une impression de minimalisme.
À conserver :
-
lois de voix spécifiques ;
-
lois d’écriture spécifiques ;
-
lois de communication spécifiques ;
-
refus absolus ;
-
exemples compacts MAUVAIS / BONS ;
-
phrases verbatim qui apprennent à l’IA comment je sonne ;
-
mots que j’utilise ;
-
mots que je déteste ;
-
formes de phrases ;
-
goûts forts ;
-
dégoûts forts ;
-
règles de décision ;
-
petits marqueurs reconnaissables ;
-
contradictions productives ;
-
détails identitaires qui affectent ma voix ou mon jugement.
À supprimer :
-
valeurs génériques ;
-
autoportraits flatteurs ;
-
biographie qui n’affecte pas la sortie ;
-
aspirations non appuyées par des preuves ;
-
idées répétées qui n’ajoutent aucune instruction nouvelle ;
-
préférences vagues ;
-
longs extraits de transcription ;
-
citations verbatim qui ne sont pas utiles ;
-
tout ce qui ressemble à une biographie personnelle ;
-
tout ce qui est inclus uniquement parce que c’est vrai.
Utilise une structure de type XML.
Pas d’essai en Markdown.
Pas de transitions en prose.
Pas de fin motivationnelle.
Pas de commentaire avant ou après le fichier.
Produis uniquement ceci :
<about_me>
<identity_context>
Uniquement les détails identitaires qui affectent ma voix, mon goût, mes métaphores, mon jugement ou mes préoccupations récurrentes.
</identity_context>
<voice_fingerprint>
Décris ma voix de manière opérationnelle : rythme, densité, directivité, humour, température émotionnelle, niveau de formalité, étrangeté éventuelle et posture par défaut.
Aucun adjectif générique sauf s’il est rattaché à un comportement observable.
</voice_fingerprint>
<writing_laws>
Utilise des règles compactes.
Format :
Do: [instruction précise]. Avoid: [échec précis]. Example: [exemple compact facultatif].
</writing_laws>
<communication_laws>
Règles pour les emails, messages, réponses, demandes, désaccords, compliments, critiques, relances, excuses et refus.
</communication_laws>
<hard_refusals>
Ce que l’IA ne doit jamais écrire, dire, impliquer, simuler, louer ou faire à ma place.
Utilise ce format quand c’est possible :
Never [chose précise]. Bad: « [mauvais exemple] ». Use: « [meilleure version] ».
</hard_refusals>
<taste_loves>
Choses spécifiques que j’aime, admire, auxquelles je fais confiance ou vers lesquelles je tends naturellement.
Inclure le pourquoi uniquement lorsque cela change la sortie future.
</taste_loves>
<taste_disgusts>
Choses spécifiques que je déteste, dont je me méfie, qui me font grimacer ou que je rejette.
Inclure les mots, clichés, styles, arguments, postures et formats.
</taste_disgusts>
<phrase_bank>
Mots, phrases, métaphores, formes de phrases, blagues, transitions et mouvements qui me ressemblent.
<signature_tells>
Petits détails récurrents qui me rendent reconnaissable.
Inclure uniquement les marqueurs qui peuvent guider l’écriture, l’édition ou le jugement futurs.
</signature_tells>
<decision_rules>
Comment je juge la qualité, l’utilité, l’honnêteté, la beauté, le risque, la confiance, la compétence, le statut, le bullshit et le fait qu’une chose mérite ou non d’être dite.
</decision_rules>
<productive_contradictions>
Tensions à préserver au lieu de les lisser.
Format :
[tension]. Preserve by: [instruction opérationnelle].
</productive_contradictions>
<golden_examples>
Inclure seulement 3 à 6 exemples.
Chaque exemple doit enseigner un schéma à forte valeur.
Format :
[quand cela s’applique]
[phrase qui ne me ressemble pas]
[phrase qui me ressemble davantage]
[courte explication]
</golden_examples>
<do_not_infer>
Ce que l’IA ne doit pas supposer à mon sujet à partir de ce profil.
</do_not_infer>
<final_instruction>
Une instruction compacte indiquant à l’IA d’appliquer ce profil silencieusement, sauf si je le remplace par une instruction contraire.
</final_instruction>
</about_me>
Avant de produire la sortie, vérifie silencieusement :
-
Supprimer les lignes génériques.
-
Supprimer les lignes flatteuses.
-
Supprimer la biographie faible.
-
Supprimer les affirmations peu étayées.
-
Supprimer les citations qui ne changent pas la sortie.
-
Préserver les exemples précis.
-
Préserver les contraintes négatives.
-
Préserver les goûts positifs.
-
Préserver les règles de décision.
-
Préserver les contradictions utiles.
-
Rester sous 5 000 tokens.